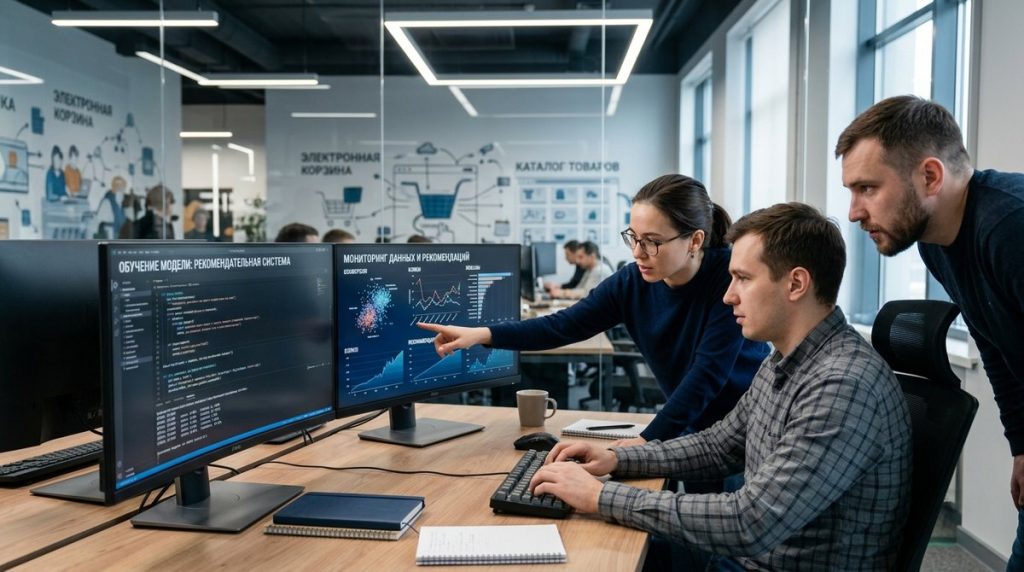
Обучение собственной модели ИИ для подбора релевантных товаров пользователю — это не просто модный тренд, а мощный инструмент роста бизнеса. Персонализированные рекомендации напрямую повышают конверсию, увеличивают средний чек и помогают удерживать клиентов, превращая разовые покупки в устойчивую лояльность. Чтобы запустить такую систему, компании нужно пройти несколько ключевых этапов: собрать и очистить пользовательские данные, выбрать подходящую архитектуру модели, провести обучение и тестирование, а затем интегрировать готовое решение в сайт или мобильное приложение.
Ключевые тезисы
- Для точных рекомендаций нужны качественные поведенческие и товарные данные.
- Выбор алгоритма зависит от зрелости данных — от коллаборативной фильтрации до нейросетей.
- Регулярное переобучение и A/B‑тесты повышают точность и бизнес‑эффект модели.
Какие данные нужны для обучения рекомендательной модели
- История взаимодействий. Основой обучения служат данные о действиях пользователя: просмотры карточек, клики, добавления в корзину, покупки. По анализу e‑commerce‑проектов за 2023 год персонализированные рекомендации обеспечивают до 31% общей выручки сайта — эти сигналы дают алгоритму понять реальные предпочтения и прогнозировать будущие интересы.
- Отзывы и оценки. Текстовые комментарии и выставленные звёзды помогают уточнить контекст: не просто факт покупки, а степень удовлетворённости. Грамотная обработка таких данных повышает точность модели, особенно при работе с новыми товарами, у которых мало статистики продаж.
- Контекст сессии. Время суток, устройство, источник трафика, геолокация, последовательность действий формируют поведенческий профиль. Например, пользователь, пришедший утром со смартфона, ищет товар быстрее, чем посетитель, исследующий ассортимент вечером с ПК. Модель должна улавливать эти различия и адаптировать выдачу.
- Качественные признаки товаров. Категория, цена, бренд, сезонность и другие параметры необходимы для связи пользовательских сигналов с характеристиками объектов. Без описательных данных невозможно объяснить, почему товар оказался релевантным — это снижает доверие к рекомендациям.
- Очистка данных. Важно отделять полезные сигналы от случайных кликов и устаревших действий. Шум ухудшает обучение и искажает картину интересов. Компании‑лидеры, по данным McKinsey за 2021 год, получают до 40% совокупной выручки за счёт точной персонализации — это результат жёсткого контроля качества данных.
- Интеграция с бизнес‑логикой. Сырые данные дают поведение, но не отражают цели компании. При разработке собственной рекомендательной модели стоит добавить внутренние метрики: маржинальность, складские остатки, приоритетные категории. Такой подход помогает системе предлагать не просто популярное, а выгодное для бизнеса.
Сравнение основных алгоритмов рекомендаций
Система рекомендаций — один из самых результативных инструментов в онлайн‑продажах. По данным McKinsey за 2021 год, компании, внедрившие персонализацию, зарабатывают до 40 % больше выручки по сравнению с игроками рынка, которые персонализацию не используют. А по данным Salesforce за 2023 год, рекомендации обеспечивают лишь 7 % визитов, но приносят до 26 % всей выручки.
Чтобы обучить модель ИИ для подбора релевантных товаров пользователю, выбирают подходящий алгоритм — от классической фильтрации до нейросетевых методов. Ниже — основные различия.
| Тип модели | Принципы работы | Сценарии использования в e‑commerce |
|---|---|---|
| Коллаборативная фильтрация | Сопоставляет пользователей по схожести покупок и оценок; предлагает товары, которые выбирали похожие клиенты. | Подбор аксессуаров или похожих товаров на основе поведения аудитории. |
| Контент‑базированная | Анализирует свойства товаров (описание, теги, изображения) и ищет совпадения с предпочтениями пользователя. | Рекомендации внутри одной категории — одежда схожего стиля, книги того же жанра. |
| Гибридная | Комбинирует несколько методов: учитывает похожесть пользователей и характеристики контента. | Оптимален для маркетплейсов с большим ассортиментом и разнообразной аудиторией. |
| Нейросеть | Обучается на больших массивах данных, выявляя скрытые зависимости между товарами, контентом и поведением клиентов. | Индивидуальные витрины в реальном времени, динамический апселл, персональные рекомендации в мобильном приложении. |
По данным исследований онлайн‑торговли, применение ИИ‑рекомендаций может повышать ключевые показатели: средний чек в сессиях с рекомендациями в ряде случаев растёт до 369 %. На практике это значит, что даже простая настройка базовой модели способна значительно увеличить выручку и эффективность маркетинга.
Пошаговая схема обучения модели ИИ для подбора товаров
- Сбор и очистка данных. На первом шаге важно собрать историю покупок, просмотров и кликов пользователей. Источник — собственные CRM и веб‑аналитика. Далее удаляются дубликаты, исправляются ошибки в товарных карточках, унифицируются категории. Без чистых данных модель будет предлагать нерелевантные позиции.
- Построение признаков. Из подготовленных данных выделяют характеристики — цена, категория, бренд, частота покупок, время взаимодействия. Например, если клиент чаще выбирает недорогие аксессуары, система должна учитывать чувствительность к цене и усиливать похожие позиции.
- Выбор и настройка модели. Используют алгоритмы коллаборативной фильтрации, факторизации матриц или нейросетевые подходы. Глубокие модели точнее отражают многокритериальные предпочтения и повышают релевантность рекомендаций. Настройка включает подбор гиперпараметров под реальные пользовательские сессии.
- Обучение и тестирование. Датасет делится на обучающую и тестовую части. После обучения модель проверяют по метрикам точности, полноты и CTR. По анализу e‑commerce‑проектов за 2023 год персонализированные рекомендации обеспечивают до 31% выручки сайта, поэтому даже небольшое улучшение метрик заметно влияет на доход.
- Внедрение и A/B‑тестирование. Готовую систему интегрируют на сайт или в приложение, параллельно запуская тестовые группы пользователей. AI‑рекомендации, согласно исследованиям онлайн‑торговли, способны заметно повышать конверсию. После подтверждения эффективности модель включают в штатную работу и подключают автоматическое обновление данных, чтобы рекомендации оставались точными без ручной корректировки.
Мнение эксперта: как связать ИИ‑рекомендации с бизнес‑результатами
Когда мы обучаем модель ИИ для подбора релевантных товаров, важно не просто повысить точность прогнозов, а добиться ощутимого эффекта — роста конверсии и выручки. По данным McKinsey за 2021 год, компании, преуспевающие в персонализации, генерируют примерно на 40% больше выручки, чем средние игроки рынка, и это видно на практике: в одном из наших проектов клиенты начали находить нужные товары вдвое быстрее, а средний чек вырос без дополнительных акций. Модель стала не просто предсказывать интерес пользователя, а училась понимать контекст — зачем он пришёл на сайт и что его удерживает. Настоящий успех ИИ виден тогда, когда его решения измеряются не в процентах точности, а в прибыли бизнеса.
Александр Холодов, Директор компании "Центр медиа технологий"
Как избежать типичных ошибок при обучении модели
Как обучить модель ИИ для подбора релевантных товаров пользователю — вопрос не только технологий, но и стратегии. Ошибки на этапе подготовки и обучения данных часто сводят на нет эффект персонализации, которая способна приносить до 40% совокупной выручки по данным McKinsey за 2021 год.
Первая ловушка — проблема “холодного старта”. Новые пользователи и товары без истории кликов не дают модели нужного контекста. Решение — гибридный подход: совмещать контентные признаки (описания, теги, категории) и поведенческие данные других клиентов. Так система сможет рекомендовать даже при минимуме информации.
Вторая ошибка — игнорирование сезонности и контекста. Модель, не чувствительная к календарным колебаниям, будет советовать зонты в июле и купальники в декабре. Корректнее использовать временные метки в тренировочных данных и регулярно обновлять обучающий набор.
Третья тема — переобучение. Алгоритм, подогнанный под прошлое, быстро теряет актуальность. Чтобы этого избежать, нужно держать баланс между точностью на обучающей выборке и результатами на тесте, а также ограничивать количество обучающих эпох.
Четвёртая угроза — дрейф данных. Со временем вкусы и ассортимент меняются, а модель остаётся “вчерашней”. Плановая переобучаемость — обязательна: пересматривать модель хотя бы ежемесячно.
И, наконец, защита персональных данных. Любая утечка ставит под удар репутацию. Оптимально — использовать деперсонифицированные данные и шифрование при передаче.
Компании, грамотно реализующие персонализацию, фиксируют рост ключевых метрик и увеличение среднего чека, в отдельных исследованиях онлайн‑торговли рост среднего чека в сессиях с рекомендациями оценивается до 369%.
Совет: Не пытайтесь обучить “идеальную” модель один раз — развивайте её как живую систему, которая учится вместе с вашим бизнесом.
Читайте также
Грамотно обученная модель ИИ превращает подбор товаров из простого фильтра в инструмент роста продаж. Индивидуальные рекомендации повышают вероятность покупки и средний чек, а пользователи чаще возвращаются на платформу, видя, что система действительно «понимает» их интересы.
Результат напрямую зависит от актуальности данных. Потребности аудитории, ассортимент и поведенческие паттерны меняются — значит, модель нужно регулярно переобучать, обновлять признаки и тестировать качество выдачи. Игнорирование этой практики ведёт к «замыливанию» рекомендаций и падению отклика.
Центр Медиа Технологий помогает компаниям пройти весь цикл — от сбора и очистки данных до создания и внедрения персонализирующих алгоритмов. Эксперты подберут архитектуру модели, настроят мониторинг качества и обеспечат масштабирование решения под бизнес‑цели клиента.
FAQ
Какие данные лучше подходят для обучения рекомендательной системы?
Наиболее ценны поведенческие данные: просмотры, клики, добавления в корзину, покупки. Их стоит дополнять контентными признаками — описанием товаров, категориями, изображениями и характеристиками. При наличии — учитывать демографию пользователей и контекст (время, устройство, местоположение). Чем богаче набор сигналов, тем точнее модель определяет интерес.
Как выбрать между коллаборативной фильтрацией и нейросетями?
Если доступна плотная матрица взаимодействий и данных немного, разумнее применить коллаборативную фильтрацию: она проще, быстрее и хорошо работает при повторяющихся паттернах. Нейросети эффективнее на больших массивах и позволяют учитывать тексты, изображения, временные зависимости. Часто используют гибридный подход: фильтрация выявляет базовые связи, сеть уточняет выдачу.
Что делать при проблеме холодного старта для новых пользователей?
Можно предложить опрос о предпочтениях, использовать данные из публичных профилей или историю просмотров без входа. Второй вариант — «популярное сейчас» или подборка по контексту (регион, устройство, время). По мере роста активности нового пользователя система быстро переходит к персонализированным рекомендациям.
Какие метрики используют для оценки качества рекомендаций?
Основные — precision@k и recall@k для измерения точности и полноты выдачи, nDCG для оценки позиции релевантных товаров. Для бизнеса анализируют CTR, конверсию и средний чек. Метрики нужно интерпретировать в связке с продуктовой целью — не только как точность модели, но и как влияние на поведение пользователей.
Как часто нужно переобучать модель, чтобы не терять точность?
Зависит от темпов изменения ассортимента и поведения аудитории. При активных распродажах и частых обновлениях каталога модель стоит обновлять каждую неделю. Для стабильных ниш достаточно раз в месяц. Если замечен спад CTR или рост ошибок, следует инициировать внеплановое переобучение с новыми логами взаимодействий.